技术 SEO 与抓取索引
共 148 篇文章 · 第 4 / 15 页
-
产品参数放折叠标签页,会影响SEO吗?关键看数据何时加载
参数折叠不必一律取消。区分预先交付的正文与点击后才取数的面板,检查手机内容、参数条件和交互可读性,让采购者能找到完整规格。
-
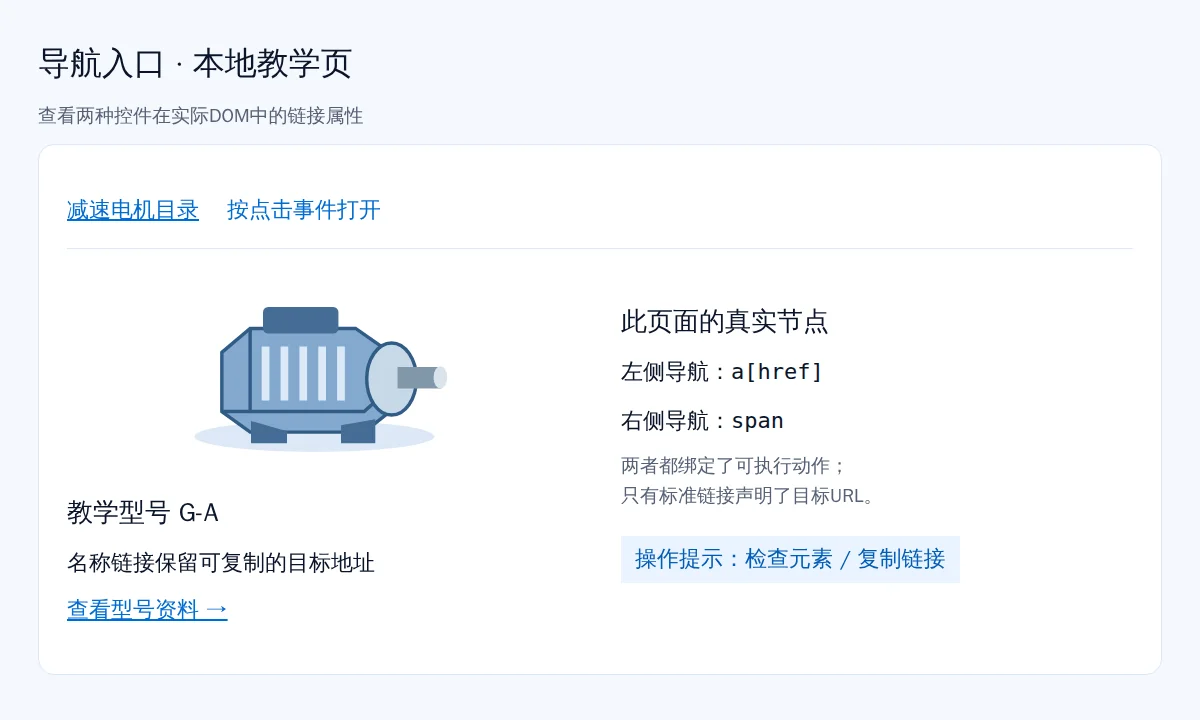
菜单点得开,谷歌却未必找得到:onclick导航怎样补上真实链接
菜单能点开不等于可抓取。用实际DOM、真实href、目标页直达与手机导航检查,修复onclick入口,同时保留前端路由和正常浏览器操作。
-
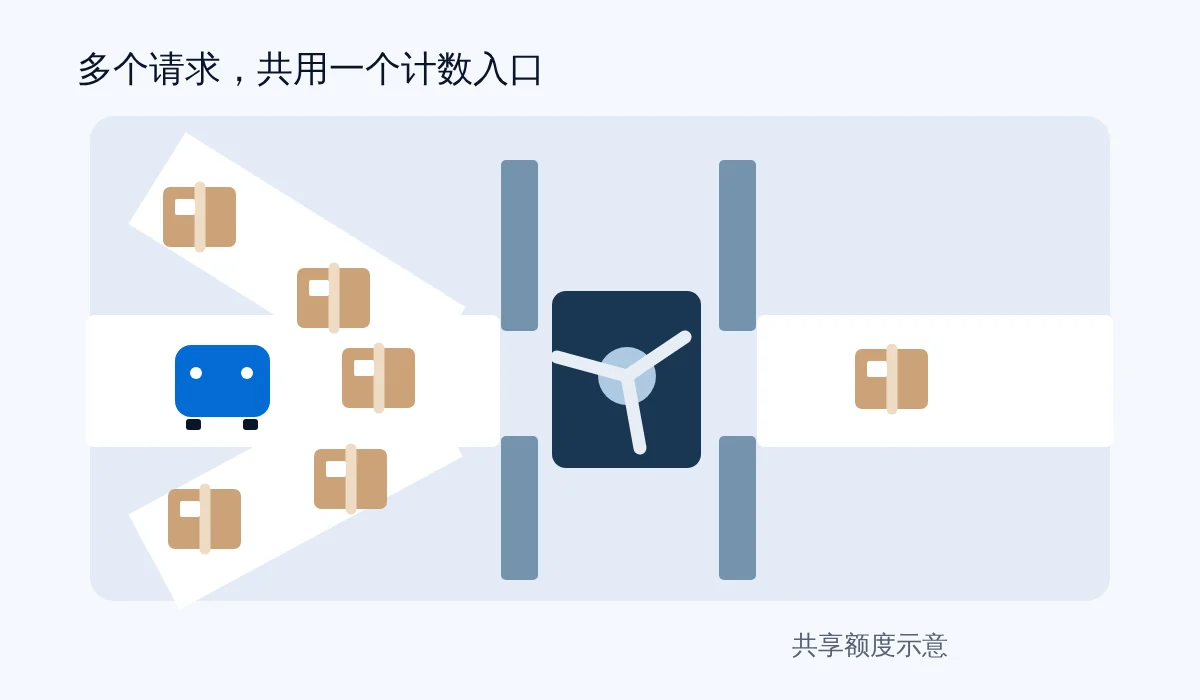
Googlebot遇到429后怎么恢复?限流规则先查计数对象
Googlebot收到429,先查限流规则按谁计数。区分共享代理IP、资源突发和真实过载,核验爬虫身份后有限调整,并说明Retry-After、临时规则撤销及抓取渐进恢复的边界。
-
偶发502、504也要修吗?按URL和时间找出抓取不稳定的来源
偶发502、504不能只靠刷新判断已修复。本文按URL、时间、缓存与上游请求ID定位间歇5xx,说明Google处理服务器错误的方式,以及原故障条件下的持续恢复检查。
-
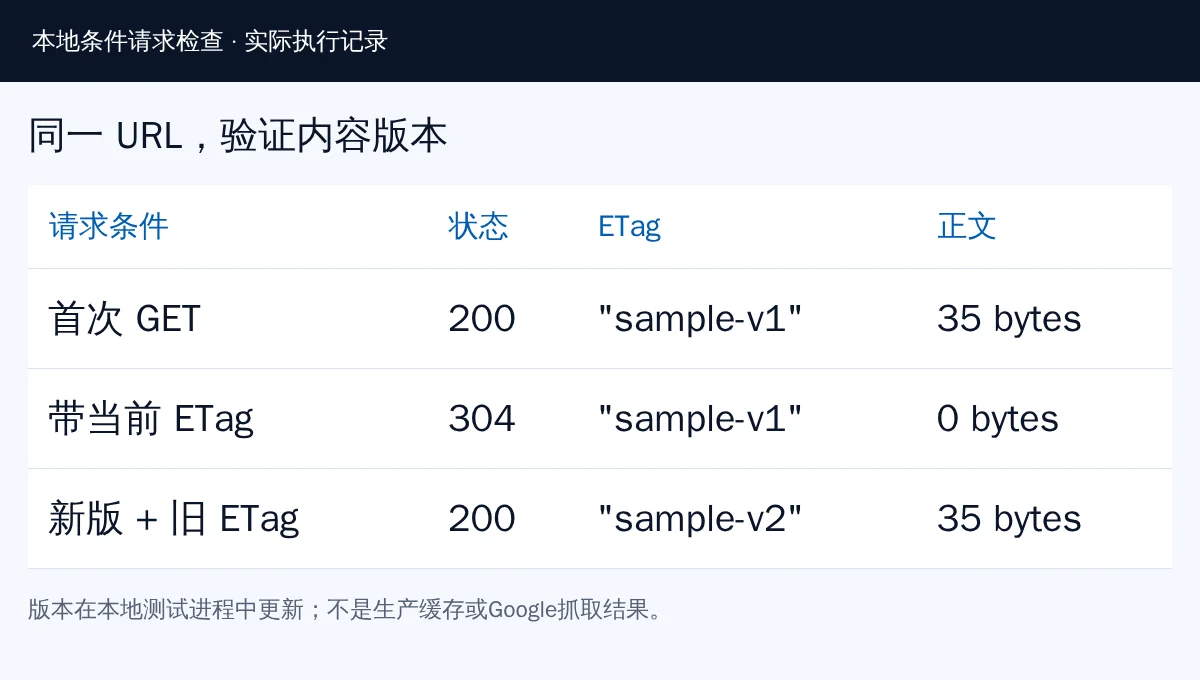
304不是抓取失败:怎样验证ETag没有把新版页面挡在外面
304通常是正确复用缓存,不是抓取失败。用首次GET、匹配ETag和内容更新后的旧ETag做对照,检查条件头优先级、弱验证器及正文版本,避免把新版页面误判为未修改。
-
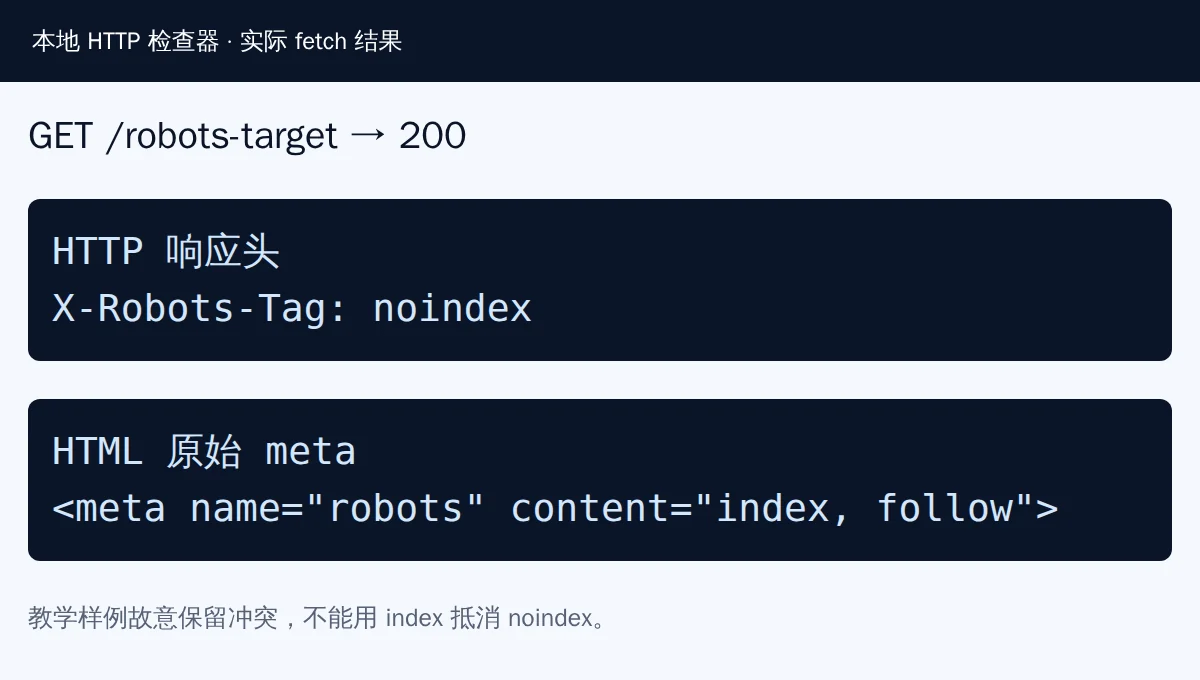
HTML写了index,响应头却有noindex:robots冲突听谁的
HTML的index不能抵消适用的X-Robots-Tag noindex。按Google更严格规则原则,检查通用与定向指令、多个响应头和输出层,分清抓取、索引、摘要限制及正文代码示例。
-
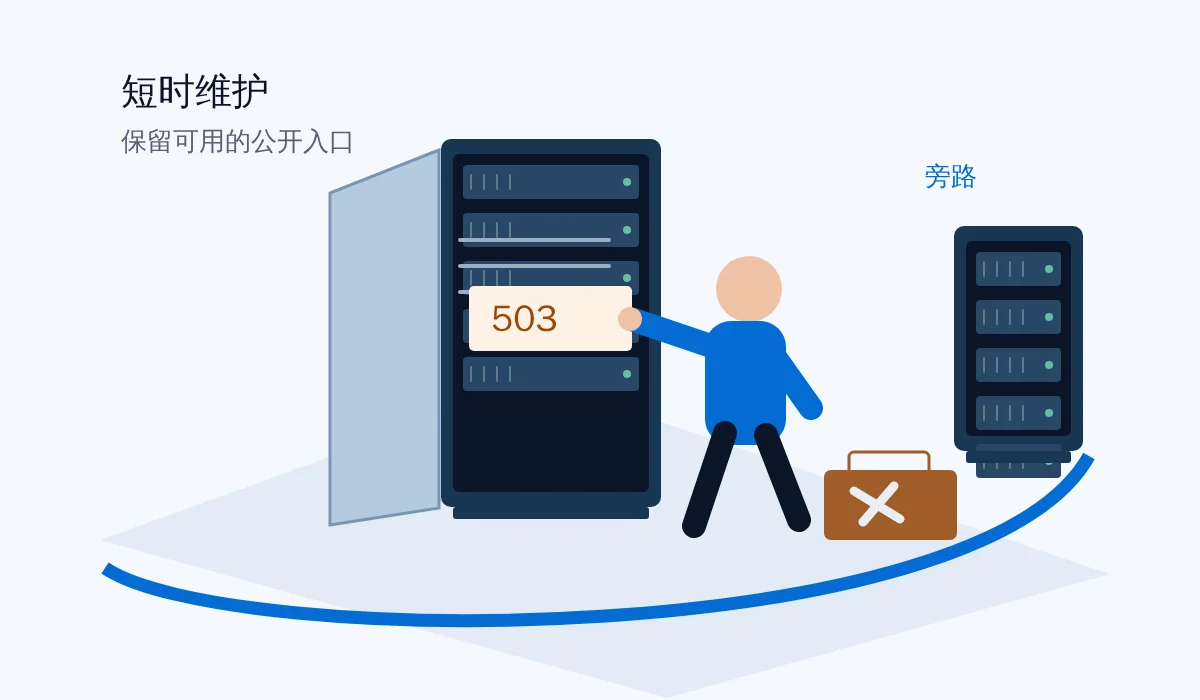
网站短时维护用503还是200?Retry-After与恢复检查要一起做
短时维护用503表达暂时不可用,Retry-After只提供重试提示。了解何时保留公开内容、为什么不用200或noindex替代、robots.txt如何处理,以及恢复正文与清理维护缓存的步骤。
-
后台已取消noindex,公网还在禁止收录:CDN旧缓存怎样查
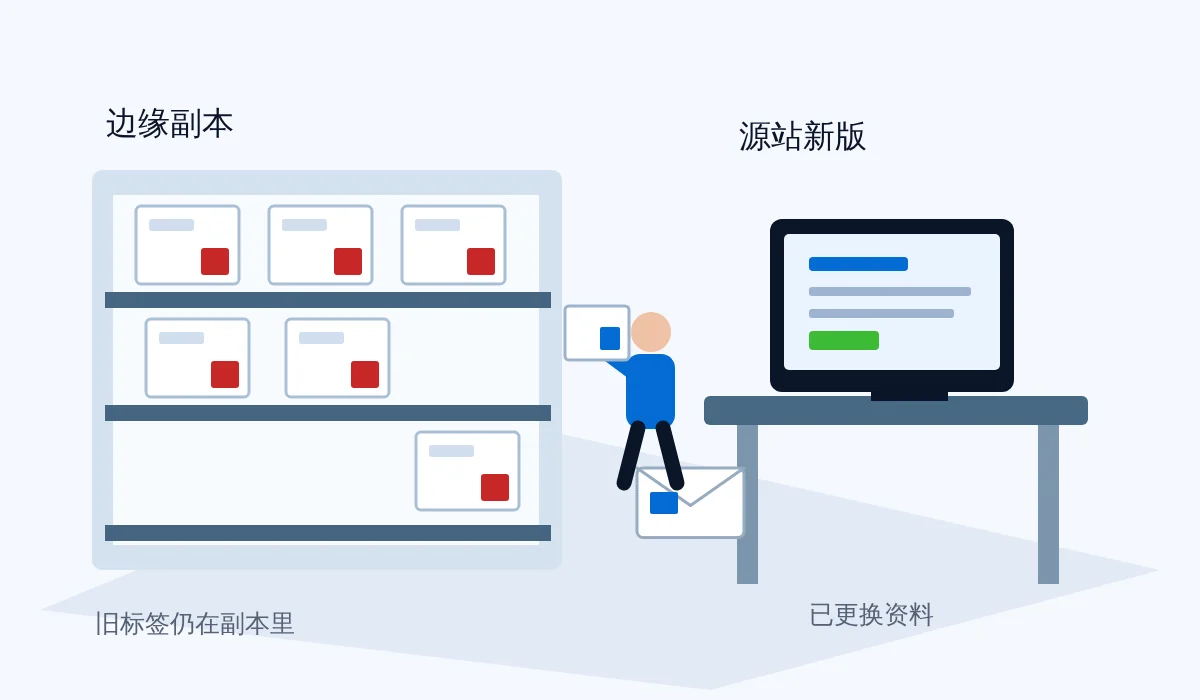
取消noindex后公网仍受限,先保存同URL的HTTP头与HTML。用正文版本、缓存迹象和源站对照,区分旧副本与边缘追加规则,说明缓存失效范围及恢复索引前的检查边界。
-
必须同意Cookie才能看正文?先把公开内容与追踪脚本拆开
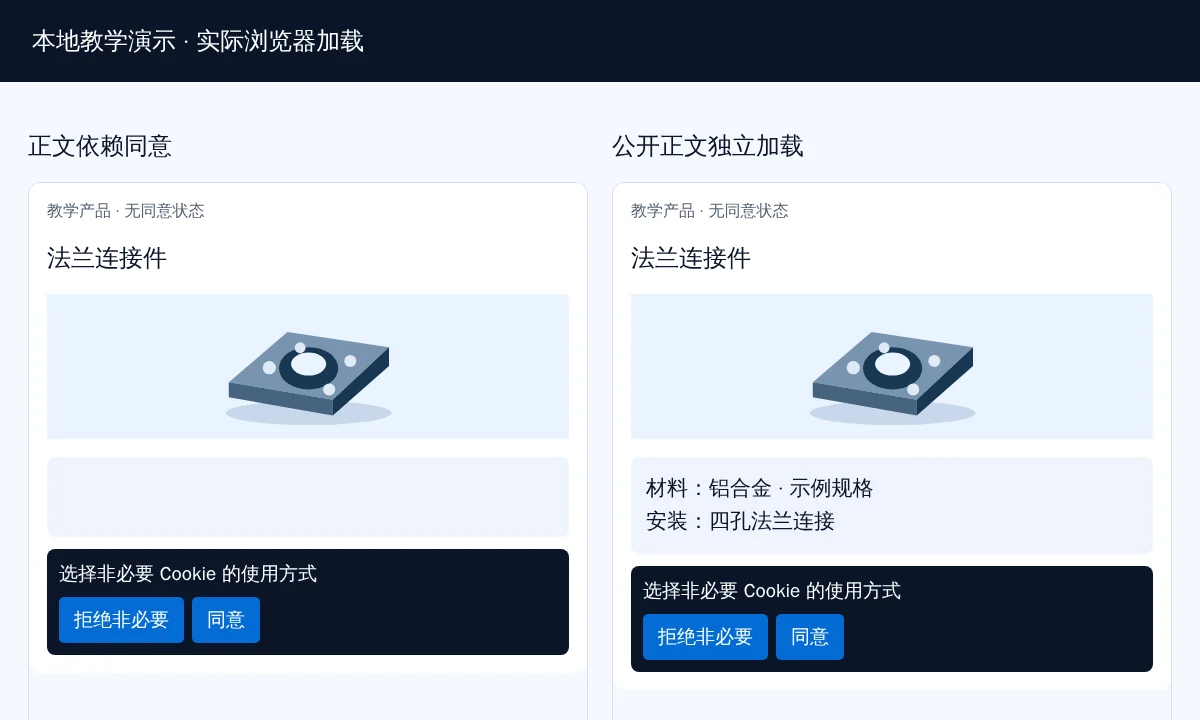
未选择或拒绝营销Cookie后,产品说明也该能正常读取。本文区分遮罩与正文未加载,说明Google跨页状态限制,并给出内容脚本拆分、深链及三种同意状态的检查方法。
-
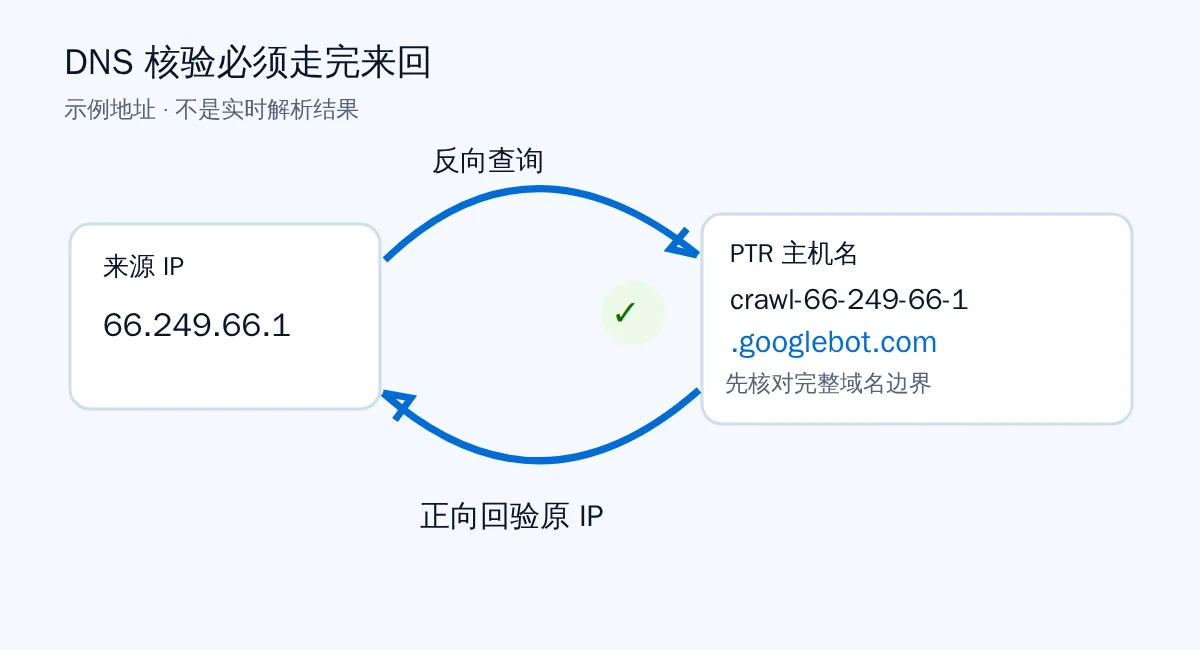
日志写着Googlebot就能放行?把反向DNS和正向验证做完整
别凭User-Agent放行Googlebot。本文从代理后的可信来源IP、PTR域名边界和正向回验讲起,说明官方IP范围的使用、超时处理及有限放行检查,不把身份验证当作收录保证。